 AutoSplitter


AutoSplitter의 발전
 Zoltán Péter
게시일: 2026년 10월 27일
2012년 – 모서리 감지
AutoSplitter 작업을 시작했을 때는 참고할 만한 기준이 없었습니다. 평판 스캐너 제조업체가 제공한 기본 스캔 소프트웨어만 사용해 봤는데, 기능이 상당히 부족했습니다.
더 나은 프로그램을 만들고 싶었지만, 테스트 환경이라고는 제 스캐너와 제 가족 사진뿐이었습니다. 사진들은 누렇게 바랜 앨범에 붙어 있지 않고, 그저 골판지 상자 안에 한데 들어 있었습니다.
그래서 거의 모든 사람에게 평판 스캐너의 희끄무레한 배경 위에 사진을 놓고 스캔하는 것이 유일한 사용 사례일 거라고 생각했습니다.
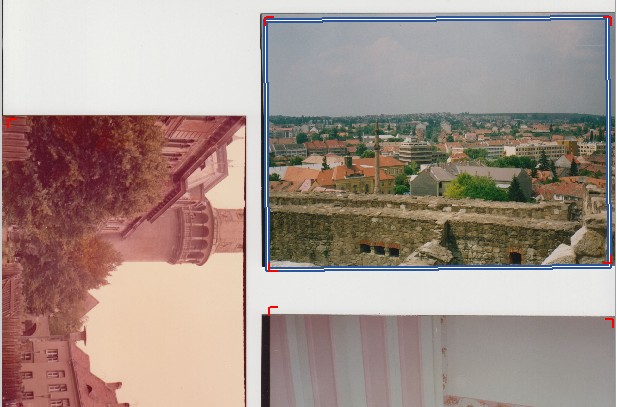
이 생각이 사진 감지 알고리즘의 첫 번째 버전으로 이어졌습니다. 작업은 간단해 보였습니다. 여러 사진이 포함된 스캔 이미지에서 어떤 픽셀이 사진에 속하고 어떤 픽셀이 스캐너 바닥에 속하는지 판별해 사진을 찾는 것입니다. 사진은 모두 직사각형이고 (대부분) 모서리가 선명합니다. 사진 모서리 주변에서는 이웃 픽셀의 25%가 사진에 속하고 75%가 배경에 속합니다. 배경은 대개 거의 흰색인 반면 사진의 내용은 보통 흰색과 거리가 멉니다.
이 논리에 따라 픽셀 그룹을 평가하면 대부분의 경우 모서리를 찾을 수 있습니다. 일부 감지는 오탐(실제 모서리가 아님)이고 일부는 미탐(감지되지 않은 모서리)입니다. 감지된 모서리 픽셀 주변의 어느 영역이 배경처럼 보이고 어느 영역이 사진의 일부처럼 보이는지에 따라 왼쪽 위, 오른쪽 위, 왼쪽 아래 또는 오른쪽 아래 모서리로 쉽게 분류할 수 있습니다.
사진의 위치를 상당히 정확하게 파악하는 데는 모서리 두세 개면 충분할 수 있습니다. 이 방법은 제 사진 모음에서 꽤 잘 작동했습니다. 모서리를 감지하지 못해 여러 사진이 잘못 합쳐지는 등의 문제가 있었지만, 그래도 스캐너에 기본으로 포함된 소프트웨어보다는 훨씬 나았습니다.
참고로, 가장자리 감지는 이미지에서 직사각형 모양을 찾는 또 다른 좋은 방법입니다. 제 알고리즘에서 전혀 사용되지 않았다고는 할 수 없지만, 사진 감지 결과를 평가하는 보조 수단으로만 쓰였습니다. 주된 방법이었던 적은 없습니다.
2019년 – 정사각형과 블록… 그리고 모서리
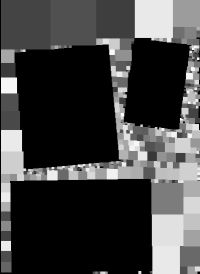
2019년 가을, 자동 감지 알고리즘을 개선하려고 수년간 반복해서 시도했지만 진전은 여전히 미미했습니다. 모서리 감지 방식을 미세 조정해 약간의 성과를 얻기는 했지만, 획기적인 개선은 아니었습니다. 사용자가 흰색 배경에서 스캔하지 않아도 작동하도록 모서리 감지 알고리즘에 여러 필터 단계를 추가했습니다. 꽤 도움이 됐지만 충분하지는 않았습니다.
다음의 큰 발전은 ‘정사각형 방식’이었습니다. IT 용어로는 연결 요소 레이블링과 볼록 껍질 피팅이라고 합니다. 상당히 단순한 아이디어입니다. 여러 필터를 사용해 입력 이미지의 모든 픽셀을 배경 또는 사진으로 분류한 다음, 모두 사진의 일부처럼 보이는 픽셀 그룹을 찾습니다. 인접한 정사각형을 그룹으로 묶으면 각 그룹이 감지된 사진의 대략적인 윤곽이 됩니다.
이 방식은 배경이 고르지 않은 경우에도 꽤 잘 작동했습니다. 명확한 사진만 감지하도록 모서리 감지 알고리즘을 훨씬 엄격하게 만들었습니다. 그런 다음 정사각형 방식으로 남은 미감지 영역을 처리해 다른 사진을 찾았습니다. 안타깝게도 사진의 회전 각도를 정확히 감지하는 방법을 알아내지 못해 사진은 항상 회전하지 않은 상태(0도)로 감지됐습니다. 그래도 모서리만 사용하는 방식에 비하면 크게 개선된 결과였습니다.
2026년 여름 – 마침내 회전하는 정사각형
자동 감지 방법을 더 개선하려고 여러 차례 실패한 끝에, 마침내 감지된 정사각형 그룹의 회전 각도를 알아낼 수 있었습니다. 그 결과 정사각형 감지는 포기하게 됐습니다. 많은 오탐과 감지 결과 병합의 근본 원인이었기 때문입니다. 하지만 또다시 결과를 더 개선하지는 못했습니다.
2026년 초가을 – 딥러닝
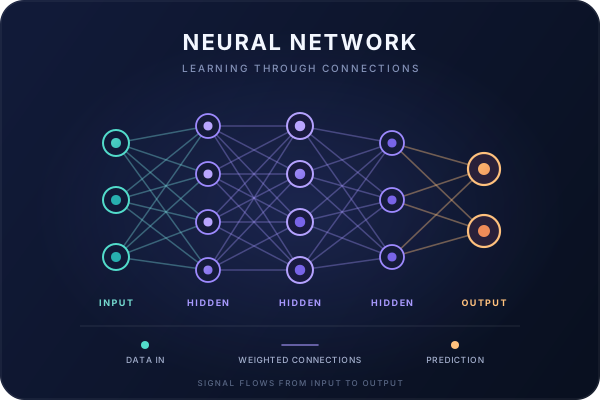
더 이상 나아갈 길이 없었습니다. 정사각형과 모서리로는 더 좋은 결과를 얻을 수 없었습니다. 알고리즘을 아무리 미세 조정해도 피할 수 없는 사실이 있었습니다. 이미지에서 직사각형 물체를 찾는 것은 쉽습니다. 어떤 픽셀이 사진에 속하는지 알아내는 것은 어렵습니다. 아주 어렵습니다. 모든 것은 각 픽셀을 단순히 이진 분류하는 데 달려 있습니다. 어떤 픽셀이 직사각형에 속하는지 정확히 판별할 수 없다면 직사각형 감지 방식을 아무리 잘 조정해도 소용없겠죠?
딥러닝은 인간의 뇌를 어느 정도 모방하는 알고리즘인 신경망을 사용합니다. 신경망을 학습시키려면 네트워크를 훈련하고 평가할 수 있도록 많은 샘플 데이터(그리고 그에 해당하는 정답)가 필요합니다. 스캔 이미지에서 사진을 감지하는 시스템을 훈련시키는 일은 쉽지 않습니다. 인터넷에서 트럭 한 대 분량의 스캔 사진을 찾을 수는 없습니다. 고객에게서 받을 수도 없었습니다. 소프트웨어는 스캔 이미지를 절대로 업로드하지 않았고, 고객들도 그런 절차를 분명히 승인하지 않았을 테니까요.
딥러닝은 매우 중요한 질문에 대한 답을 제공합니다. 이 픽셀은 사진의 일부인가, 아닌가? 이 질문에 신뢰성 있게 답할 수 있다면, 간단한 연결 요소 레이블링 알고리즘(제가 ‘정사각형’이라고 부르는 것)으로 사진을 매우 안정적으로 감지할 수 있습니다.
누구의 개인정보도 침해하지 않고 신경망 훈련에 충분한 샘플 데이터를 얻는 방법을 찾아냈습니다. 그 결과 AutoSplitter는 v1.16.1부터 사진을 매우 안정적으로 감지할 수 있게 됐습니다.
미래
현재로서는 다음에 무엇을 할지 모르겠습니다. 자동 감지 기능을 더 개선하려면 훈련 데이터를 다듬어야 할 것 같습니다. 결과는 아직 100% 정확하지 않고, 아마 앞으로도 그럴 것입니다. 어쨌든 개선할 방법이 보이면 시도해 보겠습니다.