 AutoSplitter


La evolución de AutoSplitter
 Zoltán Péter
Publicado: 27 de octubre de 2026
2012 – Detectar esquinas
Cuando empecé a trabajar en AutoSplitter, no tenía ninguna referencia real. El programa básico de escaneo que incluía el fabricante de mi escáner de cama plana era el único que había probado, y era bastante deficiente.
Quería crear algo mejor, y mi único entorno de prueba consistía en mi propio escáner y mis propias fotos familiares. No estaban pegadas en un álbum amarillento; eran simplemente un montón de fotos en una caja de cartón.
Así que supuse que escanear fotos sobre el fondo blanquecino de un escáner de cama plana sería el único caso de uso para casi todo el mundo.
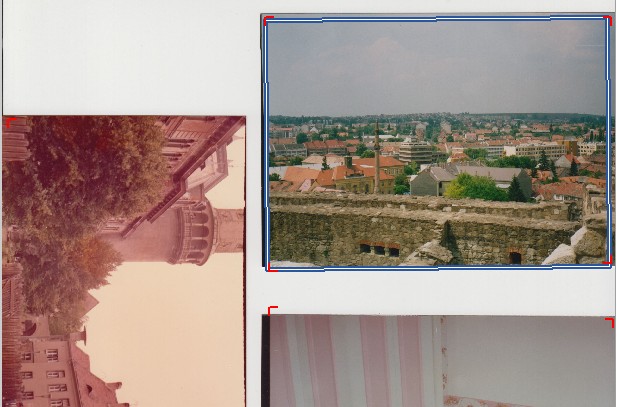
Esto inspiró la primera versión de mi algoritmo de detección de fotos. La tarea parecía obvia: dada una imagen escaneada con varias fotos, encontrarlas identificando qué píxeles pertenecen a una foto y cuáles a la superficie del escáner. Todas las fotos son rectangulares y tienen esquinas (casi siempre) nítidas. Alrededor de una esquina de una foto, el 25 % de los píxeles vecinos pertenecerá a la foto y el 75 % al fondo. El fondo suele ser casi blanco, mientras que el contenido de la foto normalmente está lejos del blanco.
Evaluar grupos de píxeles según esa lógica permite encontrar esquinas… la mayoría de las veces. Algunas detecciones son falsos positivos (en realidad no son esquinas) y otras, falsos negativos (esquinas que no se detectan). Las esquinas detectadas se pueden clasificar fácilmente como superior izquierda, superior derecha, inferior izquierda o inferior derecha, según qué segmentos alrededor del píxel de la esquina parezcan fondo y cuáles parezcan parte de una foto.
Dos o tres esquinas pueden bastar para determinar con bastante precisión la ubicación de una foto. Este enfoque funcionaba bastante bien con mis colecciones de fotos. Algunas esquinas no detectadas causaban problemas, como la unión accidental de varias fotos, pero aun así era mucho mejor que el software de fábrica que venía con mi escáner.
Como apunte, la detección de bordes es otra buena forma de encontrar formas rectangulares en una imagen. No puedo decir que nunca haya influido en mis algoritmos, pero solo se utilizó como ayuda secundaria para evaluar las detecciones de fotos. Nunca fue el método principal.
2019 – Cuadrados y bloques… y esquinas
En otoño de 2019, tras años de intentar mejorar una y otra vez el algoritmo de detección automática, todavía no había avanzado mucho. Había logrado algunas mejoras afinando el método de detección de esquinas, pero nunca fueron revolucionarias. Añadí varias capas de filtros al algoritmo para que funcionara incluso cuando los usuarios no escaneaban sobre un fondo blanco. Esto ayudó bastante, pero no lo suficiente.
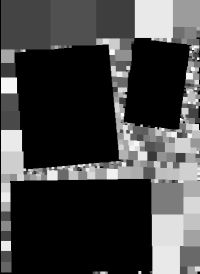
El siguiente gran avance fue el «método de los cuadrados». En informática se conoce como etiquetado de componentes conectados y ajuste de envolvente convexa. Es una idea bastante sencilla: clasificar todos los píxeles de la imagen de entrada como fondo o foto mediante distintos filtros y, después, encontrar grupos de píxeles que parezcan formar parte de una foto. Se unen los cuadrados adyacentes en grupos; cada grupo delimita aproximadamente una foto detectada.
Funcionaba bastante bien con fondos irregulares. Hice mucho más estricto el algoritmo de detección de esquinas para que detectara solo fotos evidentes. El método de los cuadrados procesaba después las zonas restantes sin detectar para encontrar las demás fotos. Por desgracia, no conseguí averiguar cómo detectar con precisión los ángulos de rotación, así que las fotos siempre se detectaban sin rotación (a 0 grados). Aun así, fue una gran mejora respecto al método basado únicamente en esquinas.
Verano de 2026 – Por fin giran los cuadrados
Después de muchos intentos fallidos por mejorar aún más mis métodos de detección automática, por fin conseguí determinar los ángulos de rotación de los grupos de cuadrados detectados. Esto me llevó a abandonar la detección de cuadrados, ya que era la causa principal de muchos falsos positivos y detecciones fusionadas. Sin embargo, una vez más, no conseguí mejorar más los resultados.
Principios del otoño de 2026 – Aprendizaje profundo
Ya no había otro camino. Los cuadrados y las esquinas no podían ofrecer mejores resultados. Por mucho que ajustara el algoritmo, quedaba un hecho inevitable: encontrar objetos rectangulares en una imagen es FÁCIL. Averiguar qué píxeles pertenecen a las fotos es difícil, MUY difícil. Todo depende de esta sencilla clasificación binaria de cada píxel. Da igual lo bien ajustado que esté el método de detección de rectángulos si no se puede identificar con precisión qué píxeles pertenecen al rectángulo, ¿verdad?
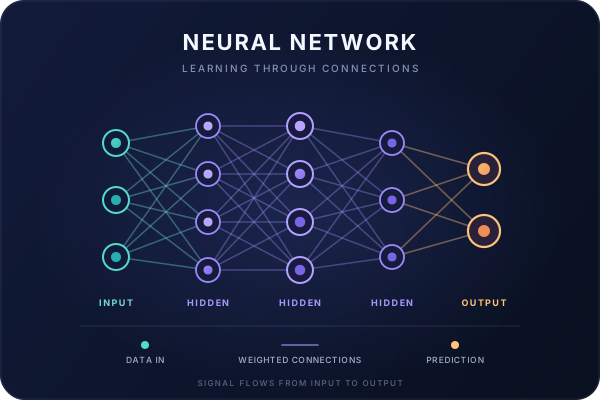
El aprendizaje profundo utiliza redes neuronales, algoritmos que imitan en cierta medida el cerebro humano. Para entrenarlas se necesitan muchos datos de ejemplo (y sus respuestas correspondientes) con los que enseñar y evaluar la red. Entrenar un sistema de detección de fotos en imágenes escaneadas no es fácil. No se puede encontrar en Internet un camión lleno de fotos escaneadas. Tampoco podía conseguirlas de mis clientes, ya que el software NUNCA subía imágenes escaneadas y, por supuesto, los clientes no aprobarían ese tipo de procedimiento.
El aprendizaje profundo ofrece la respuesta a la pregunta fundamental: ¿ESTE PÍXEL FORMA PARTE DE UNA FOTO O NO? Si se puede responder de forma fiable, un sencillo algoritmo de etiquetado de componentes conectados (al que me gusta llamar «cuadrados») puede detectar fotos con gran fiabilidad.
He encontrado una manera de obtener suficientes datos de ejemplo para entrenar la red neuronal sin comprometer la privacidad de nadie. Como resultado, AutoSplitter detecta fotos con gran fiabilidad desde la versión 1.16.1.
El futuro
Por ahora, no sé qué vendrá después. Probablemente haya que perfeccionar los datos de entrenamiento para seguir mejorando la detección automática. Los resultados aún no son 100 % precisos y probablemente nunca lo serán. En cualquier caso, si veo alguna forma de mejorarlos, lo intentaré.