 AutoSplitter


Die Entwicklung von AutoSplitter
 Zoltán Péter
Veröffentlicht: October 27, 2026
2012 – Ecken erkennen
Als ich mit der Arbeit an AutoSplitter begann, hatte ich keinen wirklichen Vergleich. Die einfache Scansoftware des Herstellers meines Flachbettscanners war die einzige Software, die ich ausprobiert hatte, und sie ließ wirklich zu wünschen übrig.
Ich wollte etwas Besseres entwickeln, und als Test hatte ich nur meinen eigenen Scanner und meine eigenen Familienfotos. Diese Fotos waren nicht in ein vergilbtes Fotoalbum geklebt, sondern lagen einfach in einem Pappkarton.
Also nahm ich an, dass das Scannen von Fotos vor dem weißlichen Hintergrund eines Flachbettscanners für fast alle der einzige Anwendungsfall sein würde.
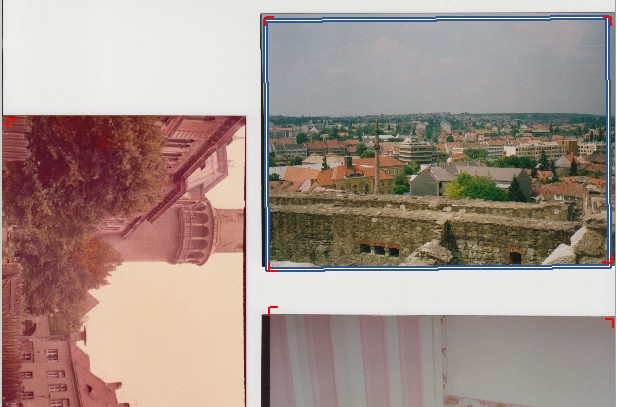
Das inspirierte die erste Version meines Fotoerkennungsalgorithmus. Die Aufgabe schien offensichtlich: Wenn ein gescanntes Bild mehrere Fotos enthält, soll man die Fotos finden, indem man ermittelt, welche Pixel zu einem Foto und welche zur Scannerfläche gehören. Alle Fotos sind rechteckig und haben (meist) scharfe Ecken. In der Umgebung einer Fotoecke gehören 25 % der benachbarten Pixel zum Foto und 75 % zum Hintergrund. Der Hintergrund ist normalerweise fast weiß, während der Bildinhalt eines Fotos meist deutlich von Weiß abweicht.
Wenn man Pixelgruppen nach dieser Logik auswertet, lassen sich meistens Ecken finden. Einige Erkennungen sind falsch positiv (es handelt sich gar nicht um Ecken), andere falsch negativ (Ecken werden nicht erkannt). Erkannte Ecken lassen sich leicht als obere linke, obere rechte, untere linke oder untere rechte Ecke einordnen – je nachdem, welche Bereiche rund um das Eckpixel wie Hintergrund und welche wie ein Teil des Fotos aussehen.
Zwei oder drei Ecken reichen aus, um die Position eines Fotos ziemlich genau zu bestimmen. Mit meinen Fotosammlungen funktionierte dieser Ansatz recht gut. Einige nicht erkannte Ecken verursachten Probleme, etwa wenn mehrere Fotos fälschlicherweise zusammengefügt wurden. Trotzdem war das Ergebnis deutlich besser als die Werkssoftware meines Scanners.
Am Rande: Kantenerkennung ist eine weitere gute Möglichkeit, rechteckige Formen in einem Bild zu finden. Ich kann nicht behaupten, dass sie in meinen Algorithmen nie eine Rolle gespielt hat, aber sie diente nur als zusätzliche Hilfe bei der Auswertung erkannter Fotos. Sie war nie der wichtigste Bestandteil.
2019 – Quadrate und Blöcke … und Ecken
Im Herbst 2019 hatte ich nach Jahren wiederholter Versuche, den automatischen Erkennungsalgorithmus zu verbessern, immer noch kaum Fortschritte gemacht. Durch die Feinabstimmung der Eckenerkennung hatte ich zwar einige Verbesserungen erreicht, aber sie waren nie revolutionär. Ich hatte mehrere Filterstufen zum Eckenerkennungsalgorithmus hinzugefügt, damit er auch dann funktioniert, wenn Nutzer nicht vor einem weißen Hintergrund scannen. Das half ziemlich, aber nicht genug.
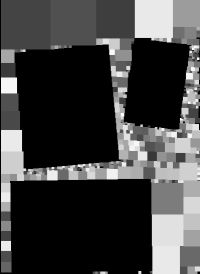
Die nächste große Entwicklung war die „Quadratmethode“. In der IT nennt man das zusammenhängende Komponentenbeschriftung und Anpassung einer konvexen Hülle. Die Idee ist recht einfach: Alle Pixel des Eingabebildes werden mithilfe verschiedener Filter als Hintergrund oder Foto klassifiziert. Anschließend sucht man Gruppen von Pixeln, die alle wie Teile eines Fotos aussehen. Angrenzende Quadrate werden zu Gruppen zusammengefasst, die jeweils ungefähr ein erkanntes Foto umranden.
Bei ungleichmäßigen Hintergründen funktionierte das recht gut. Ich verschärfte den Eckenerkennungsalgorithmus deutlich, sodass er nur noch offensichtliche Fotos erkannte. Die Quadratmethode verarbeitete dann die übrigen, noch nicht erkannten Bereiche, um weitere Fotos zu finden. Leider konnte ich nicht herausfinden, wie sich die Drehwinkel der Fotos genau bestimmen ließen. Deshalb wurden sie immer ohne Drehung (bei 0 Grad) erkannt. Trotzdem war das eine deutliche Verbesserung gegenüber dem reinen Eckenansatz.
Sommer 2026 – Quadrate drehen sich endlich
Nach vielen gescheiterten Versuchen, meine automatischen Erkennungsmethoden weiter zu verbessern, gelang es mir schließlich, die Drehwinkel für erkannte Quadratgruppen zu bestimmen. Deshalb gab ich die Quadraterkennung auf, denn sie war die Ursache vieler falsch positiver und zusammengeführter Erkennungen. Doch wieder konnte ich die Ergebnisse nicht weiter verbessern.
Früher Herbst 2026 – Deep Learning
Es gab keinen anderen Weg mehr. Quadrate und Ecken konnten keine besseren Ergebnisse liefern. Egal, wie sehr ich den Algorithmus feinabstimmte, eine unvermeidliche Tatsache blieb: Rechteckige Objekte in einem Bild zu finden, ist EINFACH. Herauszufinden, welche Pixel zu Fotos gehören, ist schwierig – SEHR schwierig. Alles hängt von dieser einfachen binären Klassifizierung jedes Pixels ab. Es spielt keine Rolle, wie gut die Rechteckerkennung abgestimmt ist, wenn man nicht genau bestimmen kann, welche Pixel zum Rechteck gehören, oder?
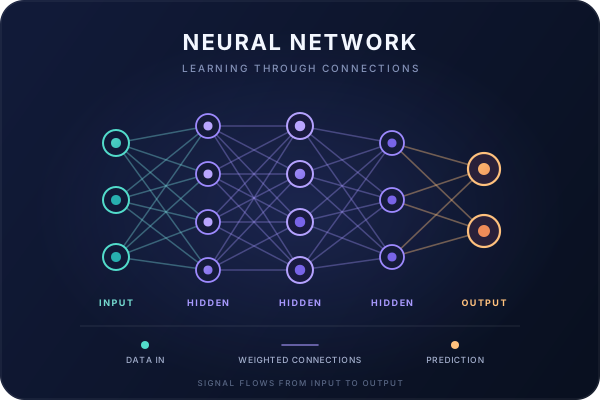
Deep Learning verwendet neuronale Netze – Algorithmen, die das menschliche Gehirn bis zu einem gewissen Grad nachahmen. Zum Trainieren neuronaler Netze braucht man viele Beispieldaten (und die dazugehörigen Antworten), um das Netz anzulernen und zu bewerten. Ein System zur Fotoerkennung in gescannten Bildern zu trainieren, ist nicht einfach. Im Internet findet man keine LKW-Ladung gescannter Fotos. Von meinen Kunden konnte ich sie auch nicht bekommen, denn die Software lud NIEMALS gescannte Bilder hoch, und meine Kunden hätten einem solchen Vorgehen ganz sicher nicht zugestimmt.
Deep Learning liefert die Antwort auf die entscheidende Frage: GEHÖRT DIESES PIXEL ZU EINEM FOTO ODER NICHT? Wenn man diese Frage zuverlässig beantworten kann, lassen sich Fotos mit einem einfachen Algorithmus zur Beschriftung zusammenhängender Komponenten (wie ich ihn gern „Quadrate“ nenne) sehr zuverlässig erkennen.
Ich habe einen Weg gefunden, genügend Beispieldaten zum Trainieren des neuronalen Netzes zu erhalten, ohne die Privatsphäre von irgendjemandem zu verletzen. Deshalb erkennt AutoSplitter seit Version 1.16.1 Fotos sehr zuverlässig.
Die Zukunft
Im Moment weiß ich nicht, was als Nächstes kommt. Wahrscheinlich müssen die Trainingsdaten verfeinert werden, um die automatische Erkennung weiter zu verbessern. Die Ergebnisse sind noch nicht zu 100 % genau und werden es wahrscheinlich auch nie sein. Wenn ich eine Möglichkeit sehe, sie zu verbessern, werde ich es jedenfalls versuchen.