 AutoSplitter


Vývoj aplikace AutoSplitter
 Zoltán Péter
Publikováno: 27. října 2026
2012 – Rozpoznávání rohů
Když jsem začal pracovat na aplikaci AutoSplitter, neměl jsem žádný skutečný vzor. Jediný software, který jsem vyzkoušel, byl základní skenovací program dodaný výrobcem mého plochého skeneru, a ten měl opravdu značné nedostatky.
Chtěl jsem vytvořit něco lepšího a jediným testovacím vybavením byl můj vlastní skener a moje vlastní rodinné fotografie. Tyto fotografie nebyly nalepené ve vybledlém albu; byla to jen hromádka fotek v kartonové krabici.
Předpokládal jsem tedy, že skenování fotografií na bělavém pozadí plochého skeneru bude pro téměř každého jediným způsobem použití.
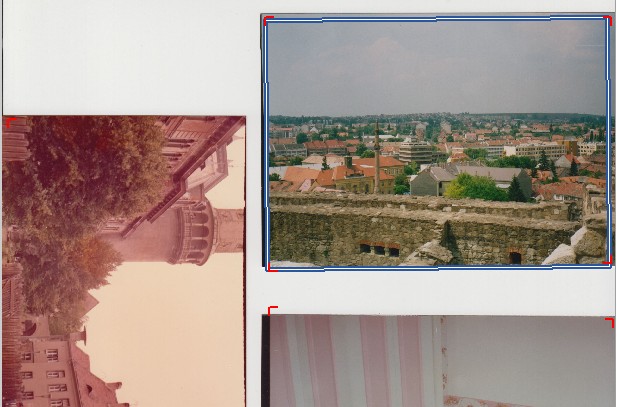
To inspirovalo první verzi mého algoritmu pro rozpoznávání fotografií. Úkol vypadal jasně: ve naskenovaném obrázku obsahujícím více fotografií najít jednotlivé fotky tím, že určíme, které pixely patří fotografii a které skenovací ploše. Všechny fotografie jsou obdélníkové a mají (většinou) ostré rohy. V okolí rohu fotografie patří 25 % sousedních pixelů fotografii a 75 % pozadí. Pozadí bývá obvykle téměř bílé, zatímco obsah fotografie se od bílé zpravidla výrazně liší.
Vyhodnocování skupin pixelů podle této logiky odhalí rohy… většinou. Některá rozpoznání jsou falešně pozitivní (ve skutečnosti nejde o rohy) a jiná falešně negativní (nerozpoznané rohy). Rozpoznané rohy lze snadno zařadit jako levý horní, pravý horní, levý dolní nebo pravý dolní roh podle toho, které oblasti kolem pixelu rohu vypadají jako pozadí a které jako součást fotografie.
Dva nebo tři rohy mohou k poměrně přesnému určení polohy fotografie stačit. Tento přístup fungoval s mými sadami fotografií docela dobře. Některé nerozpoznané rohy působily potíže, například když se několik fotografií omylem sloučilo, ale stále to bylo mnohem lepší než tovární software dodaný se skenerem.
Jen na okraj: detekce hran je další dobrý způsob, jak na obrázku najít obdélníkové tvary. Nemohu říct, že by v mých algoritmech nikdy nehrála roli, ale sloužila pouze jako doplňková pomůcka při vyhodnocování rozpoznaných fotografií. Nikdy nebyla hlavním principem.
2019 – Čtverce a bloky… a rohy
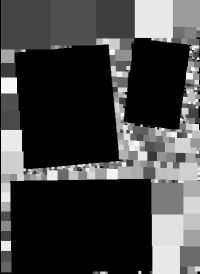
Na podzim roku 2019 jsem ani po letech opakovaných pokusů o vylepšení algoritmu automatické detekce příliš nepokročil. Nějaké zlepšení jsem dosáhl vyladěním metody rozpoznávání rohů, ale nikdy nešlo o převratné změny. Do algoritmu pro detekci rohů jsem přidal několik vrstev filtrů, aby fungoval i tehdy, když uživatelé neskenují na bílém pozadí. To pomohlo dost, ale ne dostatečně.
Dalším velkým vývojem byla „metoda čtverců“. V IT se tomu říká označování souvislých komponent a proložení konvexní obálkou. Je to poměrně jednoduchý nápad: pomocí různých filtrů označit všechny pixely vstupního obrázku jako pozadí nebo fotografii a poté najít skupiny pixelů, které všechny vypadají jako součást fotografie. Sousedící čtverce se spojí do skupin; každá skupina přibližně ohraničuje rozpoznanou fotografii.
Tento přístup fungoval docela dobře i s nerovnoměrným pozadím. Algoritmus pro detekci rohů jsem výrazně zpřísnil, aby rozpoznával jen zjevné fotografie. Metoda čtverců pak zpracovala zbývající nerozpoznané oblasti a hledala další fotografie. Bohužel jsem nedokázal přijít na to, jak přesně určit úhly otočení fotografií, takže se vždy rozpoznaly bez otočení (v úhlu 0 stupňů). Přesto šlo o velké zlepšení oproti přístupu založenému pouze na rozích.
Léto 2026 – Čtverce se konečně otáčejí
Po mnoha neúspěšných pokusech o další vylepšení metod automatické detekce se mi konečně podařilo určit úhly otočení rozpoznaných skupin čtverců. To mě přimělo detekci čtverců opustit, protože byla hlavní příčinou mnoha falešně pozitivních a sloučených rozpoznání. Ani tentokrát se mi však nepodařilo výsledky dále zlepšit.
Začátek podzimu 2026 – Hluboké učení
Už nebylo kam pokračovat. Čtverce a rohy nedokázaly přinést lepší výsledky. Ať jsem algoritmus ladil jakkoli, zůstával nevyhnutelný fakt: najít na obrázku obdélníkové objekty je SNADNÉ. Zjistit, které pixely patří fotografiím, je obtížné – VELMI obtížné. Všechno závisí na této jednoduché binární klasifikaci každého pixelu. Nezáleží na tom, jak dobře je metoda detekce obdélníků vyladěná, pokud nedokážete přesně určit, které pixely k obdélníku patří, že?
Hluboké učení využívá neuronové sítě – algoritmy, které do určité míry napodobují lidský mozek. Trénování neuronových sítí vyžaduje mnoho ukázkových dat (a odpovídajících odpovědí), na kterých se síť učí a vyhodnocuje. Natrénovat systém pro rozpoznávání fotografií v naskenovaných obrázcích není snadné. Na internetu nenajdete celý náklaďák naskenovaných fotografií. Nemohl jsem je získat ani od svých zákazníků, protože software NIKDY nenahrával žádné naskenované obrázky a zákazníci by takový postup určitě neschválili.
Hluboké učení nabízí odpověď na zásadní otázku: PATŘÍ TENTO PIXEL K FOTOGRAFII, NEBO NE? Pokud na ni dokážete spolehlivě odpovědět, jednoduchý algoritmus pro označování souvislých komponent (kterému rád říkám „čtverce“) dokáže fotografie rozpoznávat velmi spolehlivě.
Našel jsem způsob, jak získat dostatek ukázkových dat pro trénování neuronové sítě, aniž bych ohrozil soukromí kohokoli. Díky tomu AutoSplitter od verze 1.16.1 rozpoznává fotografie velmi spolehlivě.
Budoucnost
V tuto chvíli nevím, co přijde dál. Trénovací data bude pravděpodobně potřeba vylepšit, aby se automatická detekce dále zdokonalila. Výsledky zatím rozhodně nejsou stoprocentně přesné a pravděpodobně nikdy nebudou. Každopádně pokud uvidím způsob, jak je zlepšit, zkusím to.