 AutoSplitter


AutoSplitter का विकास
 Zoltán Péter
प्रकाशित: 27 अक्तूबर 2026
2012 – कोनों की पहचान
जब मैंने AutoSplitter पर काम शुरू किया, तो मेरे पास तुलना के लिए कोई वास्तविक उदाहरण नहीं था। मेरे फ़्लैटबेड स्कैनर के निर्माता द्वारा दिया गया बुनियादी स्कैनिंग सॉफ़्टवेयर ही एकमात्र सॉफ़्टवेयर था जिसे मैंने आज़माया था, और उसमें सचमुच कई कमियाँ थीं।
मैं कुछ बेहतर बनाना चाहता था, और मेरे पास परीक्षण के लिए केवल अपना स्कैनर और परिवार की अपनी फ़ोटो थीं। ये फ़ोटो किसी पीले पड़ चुके एल्बम में चिपकी नहीं थीं; वे बस एक गत्ते के डिब्बे में पड़ी फ़ोटो का ढेर थीं।
इसलिए मैंने मान लिया कि फ़्लैटबेड स्कैनर की सफ़ेद-सी पृष्ठभूमि पर फ़ोटो स्कैन करना लगभग सभी के लिए उपयोग का एकमात्र मामला होगा।
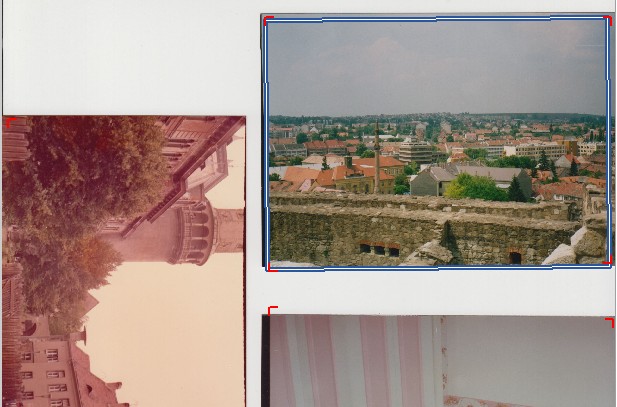
इसी से मेरे फ़ोटो-पहचान एल्गोरिदम का पहला रूप प्रेरित हुआ। काम सीधा लग रहा था: कई फ़ोटो वाली स्कैन की गई छवि में यह पता लगाना कि कौन-से पिक्सेल फ़ोटो के हैं और कौन-से स्कैनर की सतह के, और इस तरह फ़ोटो ढूँढ़ना। सभी फ़ोटो आयताकार होती हैं और उनके कोने (अधिकतर) स्पष्ट होते हैं। किसी फ़ोटो के कोने के आसपास, पास के 25% पिक्सेल फ़ोटो का हिस्सा होंगे और 75% पृष्ठभूमि के। पृष्ठभूमि आम तौर पर लगभग सफ़ेद होती है, जबकि फ़ोटो की सामग्री सामान्यतः सफ़ेद से काफ़ी अलग होती है।
इस तर्क के अनुसार पिक्सेल के समूहों का मूल्यांकन करने से अधिकतर समय कोने मिल जाते हैं। कुछ पहचानें फ़ॉल्स पॉज़िटिव होती हैं (वे वास्तव में कोने नहीं होते), और कुछ फ़ॉल्स नेगेटिव (कोने पहचान में नहीं आते)। कोने के पिक्सेल के आसपास के कौन-से हिस्से पृष्ठभूमि जैसे और कौन-से फ़ोटो के हिस्से जैसे दिखते हैं, इसके आधार पर पहचाने गए कोनों को ऊपर-बायाँ, ऊपर-दायाँ, नीचे-बायाँ या नीचे-दायाँ आसानी से वर्गीकृत किया जा सकता है।
किसी फ़ोटो की स्थिति काफ़ी सटीकता से तय करने के लिए दो या तीन कोने पर्याप्त हो सकते हैं। मेरी फ़ोटो के संग्रहों पर यह तरीका काफ़ी अच्छी तरह काम करता था। कुछ कोनों का छूट जाना समस्याएँ पैदा करता था, जैसे कई फ़ोटो का गलती से एक में जुड़ जाना, लेकिन फिर भी यह मेरे स्कैनर के साथ आए फ़ैक्टरी सॉफ़्टवेयर से कहीं बेहतर था।
एक अतिरिक्त बात: किसी छवि में आयताकार आकृतियाँ ढूँढ़ने का एक और अच्छा तरीका किनारों की पहचान करना है। मैं यह नहीं कह सकता कि मेरे एल्गोरिदम में इसकी भूमिका कभी नहीं रही, लेकिन इसका उपयोग फ़ोटो पहचान के परिणामों का मूल्यांकन करने में केवल सहायक तरीके के रूप में हुआ। यह कभी मुख्य तरीका नहीं था।
2019 – वर्ग और ब्लॉक… और कोने
2019 की शरद ऋतु तक, स्वचालित पहचान एल्गोरिदम को बेहतर बनाने की बार-बार कोशिश करते हुए कई साल बीत चुके थे, फिर भी मैंने ज़्यादा प्रगति नहीं की थी। कोने पहचानने की विधि को बारीकी से समायोजित करके कुछ सुधार ज़रूर हुए, लेकिन वे कभी क्रांतिकारी नहीं थे। मैंने कोने-पहचान एल्गोरिदम में कई फ़िल्टर परतें जोड़ीं, ताकि उपयोगकर्ता सफ़ेद पृष्ठभूमि पर स्कैन न करें तब भी यह काम करे। इससे काफ़ी मदद मिली, लेकिन पर्याप्त नहीं।
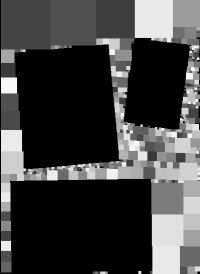
अगला बड़ा विकास “वर्ग विधि” था। आईटी की शब्दावली में इसे कनेक्टेड-कंपोनेंट लेबलिंग और कन्वेक्स-हल फ़िटिंग कहा जाता है। विचार काफ़ी सरल है: अलग-अलग फ़िल्टर का उपयोग करके इनपुट छवि के सभी पिक्सेल को पृष्ठभूमि या फ़ोटो के रूप में चिह्नित करें, फिर ऐसे पिक्सेल समूह खोजें जो सभी फ़ोटो के हिस्से जैसे दिखते हों। पास-पास के वर्गों को समूहों में जोड़ें; हर समूह लगभग एक पहचानी गई फ़ोटो की रूपरेखा बनाता है।
यह असमान पृष्ठभूमि के साथ भी काफ़ी अच्छा काम करता था। मैंने कोने-पहचान एल्गोरिदम को बहुत अधिक सख़्त बनाया, ताकि वह केवल स्पष्ट फ़ोटो को ही पहचाने। इसके बाद वर्ग विधि ने बाकी बची हुई, बिना पहचानी गई जगहों को संसाधित करके दूसरी फ़ोटो ढूँढ़ीं। दुर्भाग्य से, मैं फ़ोटो के घुमाव के कोणों को सटीक रूप से पहचानने का तरीका नहीं खोज पाया, इसलिए वे हमेशा बिना घुमाव (0 डिग्री) के पहचानी जाती थीं। फिर भी, केवल कोनों पर आधारित तरीके से यह एक बड़ा सुधार था।
2026 की गर्मियाँ – वर्ग आखिरकार घूमते हैं
अपने स्वचालित पहचान तरीकों को और बेहतर बनाने की कई नाकाम कोशिशों के बाद, मैं आखिरकार पहचाने गए वर्ग-समूहों के घुमाव के कोण तय करने में सफल हुआ। इसके बाद मैंने वर्ग-पहचान छोड़ दी, क्योंकि कई फ़ॉल्स पॉज़िटिव और मिली-जुली पहचानों की जड़ यही थी। लेकिन एक बार फिर, मैं परिणामों को और बेहतर नहीं कर पाया।
2026 की शुरुआती शरद ऋतु – डीप लर्निंग
अब आगे बढ़ने का कोई दूसरा रास्ता नहीं था। वर्गों और कोनों से बेहतर परिणाम नहीं मिल सकते थे। मैं एल्गोरिदम को कितना भी बारीकी से समायोजित करूँ, एक अपरिहार्य तथ्य बना रहा: किसी छवि में आयताकार वस्तुएँ ढूँढ़ना आसान है। कौन-से पिक्सेल फ़ोटो के हैं, यह पता लगाना कठिन—बहुत कठिन है। सब कुछ हर पिक्सेल के इस सरल द्विआधारी वर्गीकरण पर निर्भर करता है। अगर आप यह ठीक-ठीक नहीं पहचान सकते कि कौन-से पिक्सेल आयत के हैं, तो आयत-पहचान विधि को कितना भी अच्छी तरह समायोजित करने का कोई फ़ायदा नहीं, है न?
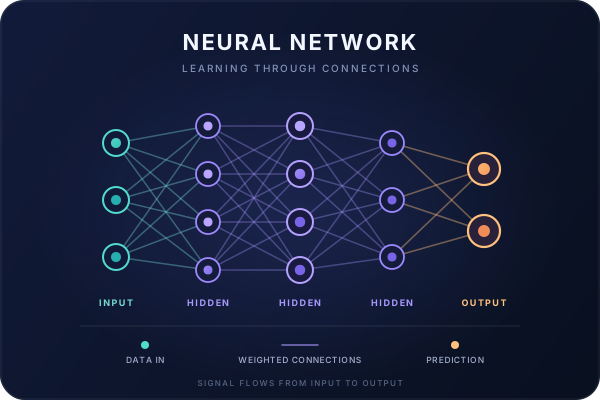
डीप लर्निंग न्यूरल नेटवर्क का उपयोग करती है—ऐसे एल्गोरिदम जो कुछ हद तक मानव मस्तिष्क की नकल करते हैं। न्यूरल नेटवर्क को प्रशिक्षित करने के लिए बहुत सारे नमूना डेटा (और उनसे जुड़े सही उत्तर) चाहिए, ताकि नेटवर्क को सिखाया और उसका मूल्यांकन किया जा सके। स्कैन की गई छवियों के लिए फ़ोटो-पहचान प्रणाली को प्रशिक्षित करना आसान नहीं है। इंटरनेट पर स्कैन की गई फ़ोटो से भरा ट्रक नहीं मिल सकता। मैं उन्हें अपने ग्राहकों से भी नहीं ले सकता था, क्योंकि सॉफ़्टवेयर स्कैन की गई कोई भी छवि कभी अपलोड नहीं करता था, और ग्राहक निश्चित रूप से ऐसी प्रक्रिया को मंज़ूरी नहीं देते।
डीप लर्निंग उस बेहद महत्वपूर्ण सवाल का जवाब देती है: क्या यह पिक्सेल किसी फ़ोटो का हिस्सा है या नहीं? अगर इस सवाल का भरोसेमंद जवाब दिया जा सके, तो एक सरल कनेक्टेड-कंपोनेंट लेबलिंग एल्गोरिदम (जिसे मैं “वर्ग” कहना पसंद करता हूँ) बहुत भरोसेमंद तरीके से फ़ोटो पहचान सकता है।
मुझे किसी की निजता से समझौता किए बिना न्यूरल नेटवर्क को प्रशिक्षित करने के लिए पर्याप्त नमूना डेटा पाने का तरीका मिल गया। नतीजतन, AutoSplitter v1.16.1 से फ़ोटो को बहुत भरोसेमंद तरीके से पहचानने में सक्षम है।
भविष्य
अभी मुझे नहीं पता कि आगे क्या होगा। स्वचालित पहचान को और बेहतर बनाने के लिए प्रशिक्षण डेटा को शायद परिष्कृत करना होगा। परिणाम अभी निश्चित रूप से 100% सटीक नहीं हैं और शायद कभी होंगे भी नहीं। फिर भी, अगर मुझे उन्हें बेहतर करने का कोई तरीका दिखा, तो मैं कोशिश करूँगा।