 AutoSplitter


De ontwikkeling van AutoSplitter
 Zoltán Péter
Gepubliceerd: October 27, 2026
2012 – Hoeken detecteren
Toen ik aan AutoSplitter begon, had ik geen echt vergelijkingsmateriaal. De eenvoudige scansoftware van de fabrikant van mijn flatbedscanner was de enige software die ik had geprobeerd, en die schoot ernstig tekort.
Ik wilde iets beters maken, en mijn enige testopstelling bestond uit mijn eigen scanner en mijn eigen familiefoto’s. Die foto’s waren niet in een vergeeld fotoalbum geplakt; het was gewoon een stapel foto’s in een kartonnen doos.
Daarom nam ik aan dat foto’s scannen tegen de witachtige achtergrond van een flatbedscanner voor vrijwel iedereen het enige gebruiksscenario zou zijn.
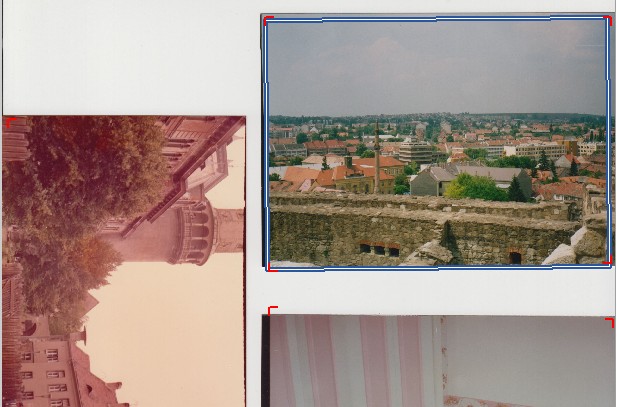
Dit vormde de inspiratie voor de eerste versie van mijn fotodetectie-algoritme. De taak leek vanzelfsprekend: vind in een gescande afbeelding met meerdere foto’s de foto’s door vast te stellen welke pixels bij een foto horen en welke bij de scannerplaat. Alle foto’s zijn rechthoekig en hebben (meestal) scherpe hoeken. Rond een hoek van een foto hoort 25% van de aangrenzende pixels bij de foto en 75% bij de achtergrond. De achtergrond is doorgaans bijna wit, terwijl de inhoud van de foto over het algemeen sterk afwijkt van wit.
Als je groepen pixels volgens die logica beoordeelt, kun je meestal hoeken vinden. Sommige detecties zijn fout-positief (het zijn in werkelijkheid geen hoeken), andere fout-negatief (hoeken die niet zijn gedetecteerd). Gedetecteerde hoeken zijn eenvoudig in te delen als linksboven, rechtsboven, linksonder of rechtsonder, afhankelijk van welke segmenten rond de hoekpixel op de achtergrond lijken en welke op een deel van een foto lijken.
Twee of drie hoeken kunnen voldoende zijn om de locatie van een foto vrij nauwkeurig te bepalen. Deze aanpak werkte behoorlijk goed met mijn fotosets. Sommige niet-gedetecteerde hoeken veroorzaakten problemen, zoals het per ongeluk samenvoegen van meerdere foto’s, maar het was nog steeds veel beter dan de fabriekssoftware die bij mijn scanner werd geleverd.
Terzijde: randdetectie is een andere goede manier om rechthoekige vormen in een afbeelding te vinden. Ik kan niet zeggen dat het nooit een rol heeft gespeeld in mijn algoritmen, maar het werd alleen gebruikt als aanvullende hulp bij het beoordelen van fotodetecties. Het was nooit de belangrijkste methode.
2019 – Vierkanten en blokken… en hoeken
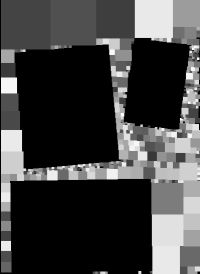
In het najaar van 2019 had ik, na jarenlang herhaaldelijk te hebben geprobeerd het automatische detectie-algoritme te verbeteren, nog steeds weinig vooruitgang geboekt. Door de hoekdetectiemethode nauwkeuriger af te stellen had ik wat winst geboekt, maar de verbeteringen waren nooit revolutionair. Ik had meerdere filterlagen aan het hoekdetectie-algoritme toegevoegd, zodat het ook werkte wanneer gebruikers niet tegen een witte achtergrond scanden. Dat hielp behoorlijk, maar niet genoeg.
De volgende grote ontwikkeling was de ‘vierkantmethode’. In de IT wordt dit connected-component labeling en convex-hull fitting genoemd. Het idee is vrij eenvoudig: label met verschillende filters alle pixels in de invoerafbeelding als achtergrond of foto en zoek vervolgens groepen pixels die er allemaal uitzien als onderdeel van een foto. Voeg aangrenzende vierkanten samen tot groepen; elke groep omlijnt bij benadering een gedetecteerde foto.
Dit werkte behoorlijk goed met ongelijkmatige achtergronden. Ik maakte het hoekdetectie-algoritme veel strenger, zodat het alleen duidelijke foto’s detecteerde. De vierkantmethode verwerkte vervolgens de resterende, niet-gedetecteerde gebieden om de andere foto’s te vinden. Helaas kon ik niet bedenken hoe ik de draaiingshoeken van foto’s nauwkeurig kon detecteren, dus werden ze altijd zonder rotatie (op 0 graden) herkend. Toch was dit een grote verbetering ten opzichte van de aanpak die alleen hoeken gebruikte.
Zomer 2026 – Vierkanten draaien eindelijk
Na veel mislukte pogingen om mijn automatische detectiemethoden verder te verbeteren, slaagde ik er eindelijk in de draaiingshoeken van gedetecteerde groepen vierkanten te bepalen. Daardoor besloot ik de vierkantdetectie achter me te laten, omdat die de oorzaak was van veel fout-positieve en samengevoegde detecties. Maar opnieuw lukte het me niet de resultaten verder te verbeteren.
Vroege herfst 2026 – Deep learning
Er was geen andere weg meer. Met vierkanten en hoeken waren geen betere resultaten te behalen. Hoeveel ik het algoritme ook verfijnde, één onvermijdelijk feit bleef staan: rechthoekige objecten in een afbeelding vinden is MAKKELIJK. Vaststellen welke pixels bij foto’s horen is moeilijk – HEEL moeilijk. Alles hangt af van deze eenvoudige binaire classificatie van elke pixel. Het maakt niet uit hoe goed de rechthoekdetectiemethode is afgesteld als je niet nauwkeurig kunt bepalen welke pixels bij de rechthoek horen, toch?
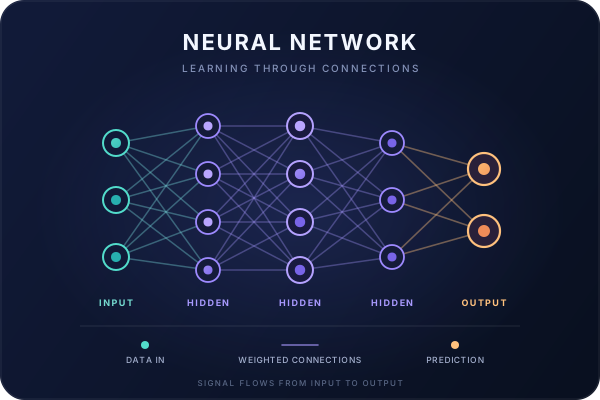
Deep learning maakt gebruik van neurale netwerken: algoritmen die het menselijk brein tot op zekere hoogte nabootsen. Voor het trainen van neurale netwerken zijn veel voorbeeldgegevens (en bijbehorende antwoorden) nodig om het netwerk te trainen en te evalueren. Een fotodetectiesysteem trainen voor gescande afbeeldingen is niet eenvoudig. Op internet vind je geen vrachtwagenlading gescande foto’s. Ik kon ze ook niet van mijn klanten krijgen, want de software uploadde NOOIT gescande afbeeldingen en klanten zouden zo’n proces beslist niet goedkeuren.
Deep learning biedt het antwoord op de uiterst belangrijke vraag: IS DEZE PIXEL ONDERDEEL VAN EEN FOTO OF NIET? Als je die vraag betrouwbaar kunt beantwoorden, kan een eenvoudig algoritme voor het labelen van verbonden componenten (dat ik graag ‘vierkanten’ noem) foto’s zeer betrouwbaar detecteren.
Ik heb een manier gevonden om voldoende voorbeeldgegevens te verzamelen om het neurale netwerk te trainen zonder iemands privacy in gevaar te brengen. Daardoor kan AutoSplitter sinds versie 1.16.1 foto’s zeer betrouwbaar detecteren.
De toekomst
Op dit moment weet ik niet wat de volgende stap is. De trainingsgegevens moeten waarschijnlijk worden verfijnd om de automatische detectie verder te verbeteren. De resultaten zijn zeker nog niet 100% nauwkeurig en dat zullen ze waarschijnlijk ook nooit zijn. Hoe dan ook, als ik een manier zie om ze te verbeteren, zal ik het proberen.